第2课 数据类型与描述统计
课程主题: 认识数据,并选择正确的描述方式
课程定位: 本节只解决"数据是什么、应该怎样描述和展示"的问题,为后续统计学方法选择奠定基础。
一、学习目标
完成本节后,应能够:
- 区分连续型变量与分类变量;
- 对连续型变量进一步判断其分布特征,并据此选择合适的描述统计指标;
- 区分分类变量中的二分类变量与多分类变量,并进一步识别多分类变量中的有序分类与无序分类;
- 正确理解均值、中位数、标准差、四分位距、频数、构成比和率等常用描述指标;
- 根据变量类型和展示目的,选择合适的统计表和统计图;
- 能够发现医学论文中常见的数据类型识别和描述统计错误。
2.1 什么是描述性统计
描述性统计(descriptive statistics)的目的,是对已有数据进行整理、概括和展示,帮助我们了解数据的基本特征和分布情况。
例如,一项临床研究纳入 200 名患者。研究者首先可能需要回答:
- 患者平均年龄是多少?
- 年龄数据集中在什么范围?
- 男性和女性各有多少人?
- 不同疾病分期分别有多少患者?
- 某项实验室指标是集中在某一区间,还是存在明显的长尾或异常值?
这些问题首先属于描述性统计,而不是组间差异检验。
在临床研究中,描述性统计常用于概括患者的年龄、血压、血糖、性别、疾病类型、疾病等级等基本特征。后续进行组间比较时,也通常会在同一张表中同时呈现描述性统计结果和比较结果。
2.2 第一步:先判断变量属于哪一种数据类型
本节首先把医学研究中的变量分成两条主要路径:
变量
├── 连续型变量
│   └── 根据分布特征
│       ├── 正态或近似正态分布
│       └── 非正态分布
│
└── 分类变量
    ├── 二分类变量
    └── 多分类变量
        ├── 无序分类变量
        └── 有序分类变量
这是本节最重要的框架。
不要看到数字以后立即选择 Mean ± SD,也不要看到"1、2、3、4"这样的编码就认为它是连续型变量。
判断的第一步永远是:
这个变量的数值究竟表示"数量",还是表示"类别"?
2.3 连续型变量:先识别变量,再判断分布
2.3.1 什么是连续型变量
连续型变量属于定量资料,其数值具有实际的数量意义。在一定范围内可以取不同数值,理论上两个数值之间还可以存在其他数值。
医学研究中的常见例子包括:
- 年龄:56.2 岁
- 收缩压:128.5 mmHg
- 血糖:6.3 mmol/L
- 体重:63.8 kg
- 某实验室检测指标:12.6 ng/mL
这些数值之间可以进行有意义的数学运算。
例如,患者 A 的收缩压为 120 mmHg,患者 B 为 140 mmHg,我们可以说两者相差 20 mmHg。
连续型变量识别完成后,下一步不能直接决定用什么方式描述,而要继续判断:
这组连续型数据呈现什么样的分布?
2.3.2 连续型变量为什么要关注分布
同样都是连续型变量,其数据形态可能完全不同。
例如两组数据的样本量都为 10:
数据 A:
48, 50, 51, 52, 53, 54, 55, 56, 57, 59
数据主要集中在中间,两端相对均衡。
数据 B:
2, 3, 3, 4, 4, 5, 6, 8, 15, 40
大多数数值集中在较低区域,但存在较大的高值,整体分布明显不对称。
如果只计算平均值,数据 B 中的 40 会明显影响均值。因此,对于不同分布形态的连续型变量,需要选择不同的描述方法。
本课程采用的基本判断逻辑是:
连续型变量
      ↓
判断数据分布
      ↓
┌─────────────────┬─────────────────┐
│ 正态/近似正态分布 │    非正态分布    │
├─────────────────┼─────────────────┤
│ Mean ± SD       │ Median (IQR)    │
│ 均值 ± 标准差    │ 中位数(四分位距) │
└─────────────────┴─────────────────┘
2.4 连续型变量的描述方法
连续型变量的描述主要涉及三个方面:
- 集中趋势------数据主要集中在哪里;
- 离散程度------数据彼此分散到什么程度;
- 分布形态------数据整体呈现什么形状。
2.4.1 集中趋势
1. 均值 Mean
均值是所有观测值之和除以观测值个数。
例如 5 名患者的收缩压分别为:
120, 125, 130, 135, 140 mmHg
均值为:
(120 + 125 + 130 + 135 + 140) / 5 = 130 mmHg
均值利用了所有观测值的信息,但也容易受到极端值影响。
如果最后一个患者不是 140 mmHg,而是 220 mmHg:
120, 125, 130, 135, 220
均值会明显升高,因此在明显非正态的数据中,仅用均值描述"典型水平"可能不合适。
2. 中位数 Median
将所有数值从小到大排列后,位于中间位置的数值称为中位数。
例如:
3, 4, 5, 7, 20
中位数为 5。
即使最大值 20 变为 100:
3, 4, 5, 7, 100
中位数仍然为 5。
因此,中位数对极端值相对不敏感,常用于描述非正态分布数据的中心位置。
3. 众数 Mode
众数是数据中出现频率最高的数值。
例如:
2, 3, 3, 3, 4, 5, 7
众数为 3。
众数可以用于描述数据的集中情况,但在医学论文连续型数据的常规报告中,Mean 和 Median 更常见。
2.4.2 离散程度
只知道"中心在哪里"还不够,还需要知道数据有多分散。
1. 标准差 Standard Deviation, SD
标准差用于反映观测值围绕均值的离散程度。
- SD 较小:数据相对集中;
- SD 较大:数据相对分散。
例如:
A组:Mean = 50,SD = 2
B组:Mean = 50,SD = 15
两组均值完全相同,但 B 组的数据波动明显更大。
因此:
Mean 告诉我们数据的中心位置,SD 告诉我们数据围绕 Mean 的离散程度。
对于正态或近似正态分布数据,常将两者组合表示为:
Mean ± SD
例如:
Age, years: 56.3 ± 12.4
2. 方差 Variance
方差也是描述数据离散程度的指标。方差越大,数据通常越分散。
标准差是方差的平方根,因此标准差与原始变量具有相同的量纲,在医学论文的数据描述中通常比方差更直观。
3. 极差 Range
极差反映最大值与最小值之间的跨度:
Range = Maximum − Minimum
例如:
最小年龄 = 20 岁
最大年龄 = 78 岁
Range = 78 − 20 = 58 岁
极差能够快速反映数据覆盖范围,但它只利用了最大值和最小值两个观测值。
4. 四分位数与四分位距 IQR
将排序后的数据划分为四个部分时,可得到第一四分位数(Q1)、中位数(Q2)和第三四分位数(Q3)。
四分位距:
IQR = Q3 − Q1
它反映中间 50% 数据所覆盖的范围。
对于非正态分布数据,通常使用:
Median (IQR)
进行描述。
在具体论文中也可能看到以 Q1--Q3 的形式直接报告,例如:
7 (4–12)
阅读论文时需要结合表头或脚注确认括号中的数值究竟表示 IQR 本身,还是 Q1--Q3。
2.5 正态分布与非正态分布
这里需要特别注意:
"非正态分布"不等于"偏态分布"。
偏态只是非正态分布的一种表现形式。因此,本课程采用"正态分布与非正态分布"的上位分类,而不是简单写成"正态分布与偏态分布"。
2.5.1 正态分布
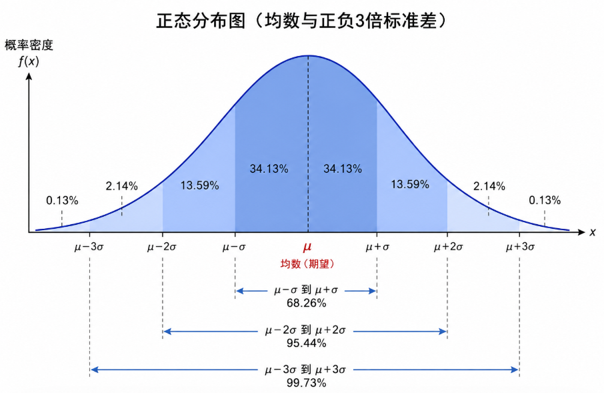
正态分布具有典型的对称形态,数据主要集中在均值附近,并向两侧逐渐减少。
对于正态分布,课件给出了经典的范围规律:
| 区间 | 约覆盖比例 |
|---|---|
| μ ± 1σ | 68.27% |
| μ ± 2σ | 95.45% |
| μ ± 3σ | 99.73% |
其中:
- μ 表示总体均值;
- σ 表示总体标准差。
这有助于理解为什么 Mean 和 SD 可以共同描述近似正态分布数据的中心和离散程度。
2.5.2 非正态分布
如果数据不符合正态分布,则属于非正态分布。
实际数据中常见的一种非正态形态是偏态分布。
右偏 / 正偏
右侧拖尾较长:
多数数值较小 + 少数特别大的数值
例如:
2, 3, 3, 4, 5, 6, 8, 15, 40
高值形成右侧长尾。
左偏 / 负偏
左侧拖尾较长:
少数特别小的数值 + 多数数值集中在较高区域
判断"左偏"还是"右偏"时,应看拖尾方向,而不是峰的位置。
2.5.3 偏度与峰度
课件进一步介绍了两个描述分布形态的指标。
偏度 Skewness
偏度主要描述分布的对称性。
- S > 0:右偏,也称正偏;
- S < 0:左偏,也称负偏;
- S 接近 0:提示分布较为对称。
需要注意:
"偏度接近 0"首先说明数据较为对称,不能仅凭这一点完成全部正态性判断。
峰度 Kurtosis
峰度用于描述分布形态的陡缓程度。
课件中的表达为:
- K > 0:峰态较陡峭;
- K < 0:峰态较平缓;
- K 接近 0:峰态接近相应的正态参考状态。
课件还介绍了使用偏度和峰度的 Z-score 辅助判断正态性的思路。这类指标可以作为分布判断的信息之一。
2.6 连续型变量:描述方法的完整判断链
到这里,可以把连续型变量的处理浓缩成一条完整路径:
确认是连续型变量
        ↓
观察和判断数据分布
        ↓
 ┌──────────────┬──────────────┐
 │正态/近似正态 │   非正态      │
 └──────┬───────┴──────┬───────┘
        ↓              ↓
   Mean ± SD      Median (IQR)
        ↓              ↓
均值描述中心位置    中位数描述中心位置
SD描述离散程度     IQR描述离散程度
例1:年龄
假设某研究纳入 100 名患者,年龄分布近似正态:
Age: 56.3 ± 12.4 years
含义是:
- 56.3 岁:均值;
- 12.4 岁:标准差。
例2:住院时间
假设患者住院时间存在明显右侧长尾,大多数患者住院时间较短,但少数患者住院时间很长。
此时更适合报告:
Length of stay: 7 (4–12) days
如果表注规定括号内为 Q1--Q3,则表示:
- 中位住院时间:7 天;
- Q1:4 天;
- Q3:12 天。
这里不应仅仅因为"住院时间是连续型变量"就自动使用 Mean ± SD。
2.7 分类变量:先看类别数,再看是否有顺序
分类变量用于表示研究对象属于哪个类别,其数值或文字主要代表类别归属,而不是连续的数量大小。
例如:
Sex:
0 = Female
1 = Male
这里的 0 和 1 是编码。
不能因为变量在数据库中写成数字,就把它当作连续型变量。
分类变量的判断路径为:
分类变量
├── 二分类变量
└── 多分类变量
    ├── 无序分类变量
    └── 有序分类变量
2.7.1 二分类变量
二分类变量只有两个互斥类别。
常见例子:
性别:Male / Female
吸烟:Yes / No
复发:Yes / No
死亡:Yes / No
治疗反应:Response / No response
例如 200 名患者中:
Male      120
Female     80
可以描述为:
Male, n (%): 120 (60.0%)
Female, n (%): 80 (40.0%)
2.7.2 多分类变量
当变量存在三个或三个以上类别时,可视为多分类变量。
多分类变量还要继续判断:
类别之间是否存在天然顺序?
A. 无序多分类变量
不同类别之间不存在高低、轻重或前后等级。
例如:
Blood type:
A
B
AB
O
或者:
Treatment:
Surgery
Radiotherapy
Chemotherapy
这些类别只是不同类型,不能说 A 型血"高于"B 型血,也不能因为给治疗方式编码为 1、2、3,就认为 3 比 1"大"。
B. 有序多分类变量
不同类别之间存在明确的等级顺序。
例如:
Disease severity:
Mild
Moderate
Severe
或者:
Stage:
I
II
III
IV
这些类别存在顺序,但类别之间的"距离"不一定相等。
例如把疾病严重程度编码为:
1 = Mild
2 = Moderate
3 = Severe
只能说明:
Mild < Moderate < Severe
不能由此直接解释为:
Severe 是 Mild 的 3 倍
因此:
有序分类变量有顺序,但编码数字本身并不自动具有连续型变量的数量意义。
2.8 分类变量如何描述
分类变量通常使用:
频数 n
百分比 %
即医学论文中最常见的:
n (%)
例如某研究共纳入 250 名患者:
| Disease stage | n | % |
|---|---|---|
| Stage I | 50 | 20.0 |
| Stage II | 75 | 30.0 |
| Stage III | 100 | 40.0 |
| Stage IV | 25 | 10.0 |
| Total | 250 | 100.0 |
这里既保留了每个类别的实际人数,又显示了各类别在总体中的构成。
2.8.1 频数 Frequency
频数回答:
有多少个?
例如:
男性患者 = 120 人
120 就是男性类别的频数。
2.8.2 构成比 Proportion
构成比回答:
某一类别占总体的多少?
例如:
总患者 = 200
男性 = 120
则男性构成比为:
120 / 200 × 100% = 60%
所以可以报告:
Male: 120 (60.0%)
2.8.3 率 Rate
课件将"率"列为分类资料常见的描述指标之一。
在阅读医学论文时,需要特别注意"百分比"和"率"的具体含义及其分母,不能只看到
% 就忽略其统计含义。
因此,审核分类变量时至少要检查:
- 分子是什么?
- 分母是什么?
- n 与 % 是否对应?
- 各互斥类别是否与总样本量一致?
- 百分比加总是否在合理的四舍五入误差范围内?
2.9 连续型变量与分类变量:不要混用描述方法
下面是本节最需要掌握的对应关系。
| 变量类型 | 进一步判断 | 主要描述方法 | 示例 |
|---|---|---|---|
| 连续型变量 | 正态/近似正态 | Mean ± SD | Age: 56.3 ± 12.4 years |
| 连续型变量 | 非正态 | Median (IQR) | Hospital stay: 7 (4–12) days |
| 二分类变量 | 两个类别 | n (%) | Male: 120 (60.0%) |
| 无序多分类变量 | ≥3 类、无顺序 | 各类别 n (%) | A/B/AB/O blood type |
| 有序多分类变量 | ≥3 类、有顺序 | 各等级 n (%) | Stage I/II/III/IV |
常见错误 1:分类变量计算均值
Male = 1
Female = 2
Mean sex = 1.46
这种表达没有正常的医学解释,因为 1 和 2 只是类别编码。
常见错误 2:连续型变量不判断分布就使用 Mean ± SD
Hospital stay = 8.7 ± 12.6 days
如果住院时间高度非正态,仅看到它是"数值变量"就使用 Mean ± SD 是不充分的。应进一步检查其分布,再决定描述形式。
常见错误 3:有序分类变量被数字编码"伪装"成连续型变量
Stage I = 1
Stage II = 2
Stage III = 3
Stage IV = 4
编码后仍然首先是有序分类变量,而不是因为出现 1、2、3、4 就自然成为连续型变量。
2.10 统计表:什么变量应该怎样放进表格
医学论文中的描述性统计经常集中出现在基线特征表或一般资料表中。
一个常见的结构可以是:
| Variable | Treatment group (n=100) | Control group (n=100) |
|---|---|---|
| Age, years | 56.3 ± 12.4 | 55.8 ± 11.9 |
| Hospital stay, days | 7 (4–12) | 8 (5–13) |
| Male, n (%) | 62 (62.0) | 58 (58.0) |
| Disease stage, n (%) | ||
| I | 15 (15.0) | 17 (17.0) |
| II | 30 (30.0) | 28 (28.0) |
| III | 40 (40.0) | 38 (38.0) |
| IV | 15 (15.0) | 17 (17.0) |
这张表同时体现了三种不同的数据表达逻辑:
- Age:连续型、近似正态 → Mean ± SD;
- Hospital stay:连续型、非正态 → Median(IQR/Q1--Q3,需由表注明确);
- Sex / Disease stage:分类变量 → n (%)。
因此,审核一张医学论文表格时,不应只看格式是否整齐,而应逐行问:
这个变量是什么类型?这种描述方式与变量类型及分布是否匹配?
2.11 统计图:根据变量类型和展示目的选择
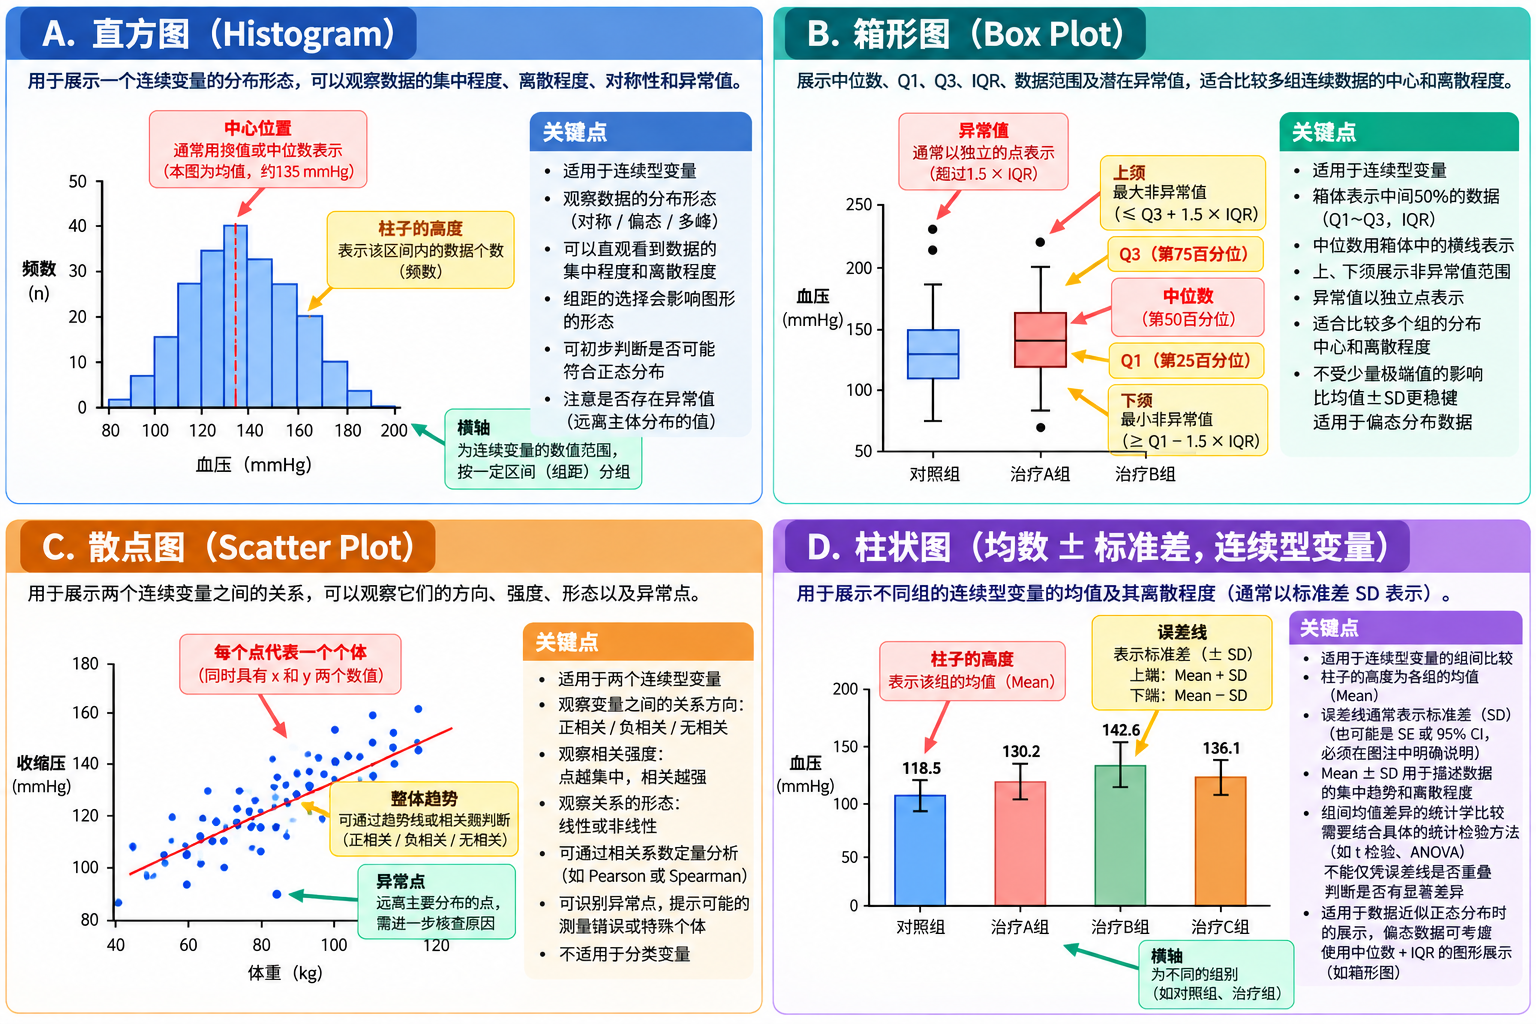
统计图的选择不能只看"哪一种图漂亮",而应该首先回答:
我要展示的是一个变量的分布、不同类别的数量,还是两个变量之间的关系?
2.11.1 连续型变量------观察分布:频数分布直方图
**频数分布直方图(histogram)**适合观察连续型数据的整体分布情况。
它可以帮助观察:
- 数据主要集中在哪个区域;
- 数据是否大致对称;
- 是否存在明显长尾;
- 数据离散程度如何;
- 是否可能存在多个峰。
例如,要观察 300 名患者年龄的分布,可将年龄划分为若干连续区间,绘制直方图。
需要理解:
直方图的主要价值不是展示"平均年龄是多少",而是让我们看到整个年龄数据的分布形态。
2.11.2 连续型变量------观察中位数、四分位数和异常值:箱形图
**箱形图(box plot)**可以展示:
- 中位数;
- 第一四分位数 Q1;
- 第三四分位数 Q3;
- 四分位距 IQR;
- 数据范围;
- 潜在异常值。
例如比较治疗组和对照组的住院时间,如果数据存在非正态分布或异常值,箱形图可以直观显示两组数据的中心位置、离散程度以及异常观测。
2.11.3 两个连续型变量------观察关系:散点图
**散点图(scatter plot)**用于展示两个变量之间的关系。
例如研究:
X轴:Age
Y轴:Systolic blood pressure
每一个点代表一名患者。
通过散点图可以直观观察:
- 两个变量是否呈现共同变化趋势;
- 趋势方向如何;
- 是否存在明显异常点;
- 数据关系是否可能是线性的或呈其他形态。
因此散点图回答的问题与直方图不同:
直方图:一个连续型变量“怎么分布?”
散点图:两个变量“有什么关系?”
2.11.4 分类变量------展示频数或构成:柱状图
对于分类变量,可以使用柱状图展示不同类别的频数或百分比。
例如疾病分期:
Stage I      20%
Stage II     30%
Stage III    40%
Stage IV     10%
柱状图可以直观比较不同类别的构成。
课件中还展示了使用柱形及误差线呈现各组均值及变异信息的示例。因此在阅读论文图形时,应同时确认:
- 柱高表示什么统计量;
- 误差线表示 SD、SE、CI 还是其他指标;
- 图注是否说明清楚。
2.12 图表选择速查表
| 数据/目的 | 推荐展示形式 | 主要观察内容 |
|---|---|---|
| 连续型变量,观察整体分布 | 频数分布直方图 | 集中、离散、对称性、长尾等 |
| 连续型变量,观察中位数、四分位数和异常值 | 箱形图 | Median、Q1、Q3、IQR、异常值 |
| 两个连续型变量,观察变量关系 | 散点图 | 方向、趋势、异常点 |
| 分类变量,展示各类别数量或构成 | 频数/百分比表、柱状图 | n、%、类别差异 |
| 多组连续型变量,展示汇总值 | 汇总统计表;必要时使用带误差线的柱形图 | Mean 及相应误差指标等 |
2.13 一套完整的医学论文判断实例
假设一项临床研究纳入 240 名患者,数据库包含以下变量:
Age
Blood pressure
Length of hospital stay
Sex
Smoking
Disease type
Disease stage
不要立即开始计算。首先逐个判断。
Step 1:Age
年龄具有实际数量意义。
→ 连续型变量
→ 判断分布
→ 若近似正态:Mean ± SD
→ 若非正态:Median (IQR)
Step 2:Blood pressure
血压具有实际数量意义。
→ 连续型变量
→ 判断分布
→ 再决定 Mean ± SD 或 Median (IQR)
Step 3:Length of hospital stay
住院时间是数值变量,但不能因为是数值就自动写成 Mean ± SD。
→ 连续型变量
→ 检查分布
→ 如果明显非正态
→ Median (IQR)
Step 4:Sex
Male / Female
→ 分类变量
→ 二分类
→ n (%)
Step 5:Smoking
Yes / No
→ 分类变量
→ 二分类
→ n (%)
Step 6:Disease type
假设:
Type A / Type B / Type C
各类别不存在等级关系:
→ 分类变量
→ 多分类
→ 无序分类
→ 各类别 n (%)
Step 7:Disease stage
假设:
Stage I / II / III / IV
存在明确顺序:
→ 分类变量
→ 多分类
→ 有序分类
→ 各等级 n (%)
经过这一步以后,数据的基本结构已经清楚。只有先把变量识别正确,后续描述统计和统计学方法的选择才有正确的起点。
2.14 医学论文编辑审核时重点看什么
面对一篇稿件的 Table 1 或结果表,可以按照下面的顺序检查。
第一层:变量类型是否识别正确
先判断:
连续型?
还是分类变量?
如果是分类变量:
二分类?
还是多分类?
如果是多分类:
有序?
还是无序?
第二层:连续型变量是否考虑分布
连续型变量继续检查:
正态/近似正态?
还是非正态?
再核对:
Mean ± SD
还是
Median (IQR)
第三层:分类变量是否正确报告 n (%)
重点检查:
- n 是否为整数;
- n 与总样本量是否一致;
- % 的分母是什么;
- n 与 % 能否相互对应;
- 互斥类别加总是否合理。
第四层:图表是否真正匹配数据和展示目的
例如:
- 想看一个连续变量的分布 → 直方图;
- 想看中位数、四分位数和异常值 → 箱形图;
- 想看两个连续变量之间的关系 → 散点图;
- 想比较分类变量各类别的频数或构成 → 表格或柱状图。
2.15 本节核心框架
最后只需要记住下面这棵判断树:
拿到一个变量
     ↓
它是什么类型?
     ↓
┌──────────────────┬──────────────────┐
│    连续型变量      │     分类变量       │
└────────┬─────────┴────────┬─────────┘
         ↓                  ↓
     判断分布             判断类别数
         ↓                  ↓
 ┌───────┴───────┐     ┌────┴─────────┐
 │               │     │              │
正态/近似正态   非正态  二分类         多分类
 │               │     │              ↓
Mean ± SD   Median(IQR) n(%)     ┌────┴────┐
                                  │         │
                                无序       有序
                                  │         │
                                n(%)      n(%)
然后再问:
我想展示什么?
- 展示连续变量的分布 → 直方图;
- 展示中位数、四分位数和异常值 → 箱形图;
- 展示两个连续变量的关系 → 散点图;
- 展示分类变量的频数和构成 → 统计表或柱状图。
2.16 本节小结
本节最重要的不是记住几个统计学名词,而是建立固定的数据判断顺序:
先识别变量类型 → 再判断数据特征 → 再选择描述指标 → 最后选择统计表和统计图。
对于连续型变量:
连续型变量 → 判断分布 → 正态/近似正态使用 Mean ± SD;非正态通常使用 Median (IQR)。
对于分类变量:
分类变量 → 二分类或多分类 → 多分类再区分有序与无序 → 主要使用 n (%) 描述。
这一步完成以后,下一节才能进一步讨论:
根据研究目的、变量类型、组数、数据分布以及研究设计,应当选择哪一种统计学检验方法。